SecOps : de l’alerte à la réponse, sans cloisonner sécurité et IT
SecOps, pour Security Operations, désigne les opérations de sécurité qui associent les équipes cybersécurité et les équipes d’exploitation informatique. Leur mission : surveiller les environnements numériques, détecter les menaces et coordonner la réponse aux incidents. Cette démarche repose sur des personnes, des processus et des technologies, avec un objectif concret : protéger l’activité sans dissocier sécurité et disponibilité des services.
SecOps : une organisation commune, pas un outil supplémentaire
Une alerte de sécurité ne se résout pas toujours depuis une console. Il faut parfois désactiver un compte, isoler un ordinateur, corriger une configuration cloud ou restaurer une application. Ces actions mobilisent plusieurs équipes, dont les priorités peuvent diverger : les unes cherchent à contenir la menace, les autres à maintenir le service.
SecOps organise cette responsabilité partagée. La sécurité apporte l’analyse des risques et des attaques ; l’exploitation IT fournit la connaissance des systèmes et les moyens d’intervention. Ensemble, elles définissent les règles d’escalade, les autorisations et les procédures de rétablissement. Le périmètre couvre les terminaux, identités, réseaux, applications et données, dans les infrastructures locales, hybrides ou multicloud.
La différence entre SecOps, SOC et DevSecOps
Le SOC, ou centre des opérations de sécurité, est une fonction opérationnelle chargée notamment de surveiller, qualifier et investiguer les alertes. Il peut être interne, externalisé ou hybride. SecOps désigne une démarche plus large de coordination entre sécurité et exploitation : un SOC peut donc en être une composante, sans résumer toute l’organisation.
Contrairement à une approche cloisonnée, où la sécurité transmet ses recommandations à l’IT sans suivi commun, SecOps prévoit une coopération continue. DevSecOps concerne davantage l’intégration de la sécurité dans le développement et la livraison des logiciels. Les deux approches se complètent, notamment lorsque les incidents en production révèlent des corrections à intégrer aux applications.
De la connexion suspecte au rétablissement du service
Prenons une connexion inhabituelle sur un compte professionnel, suivie d’un téléchargement important de documents. Ce scénario ne prouve pas, à lui seul, une compromission. Le rôle de SecOps consiste à transformer ces signaux en décision argumentée, puis en actions coordonnées.
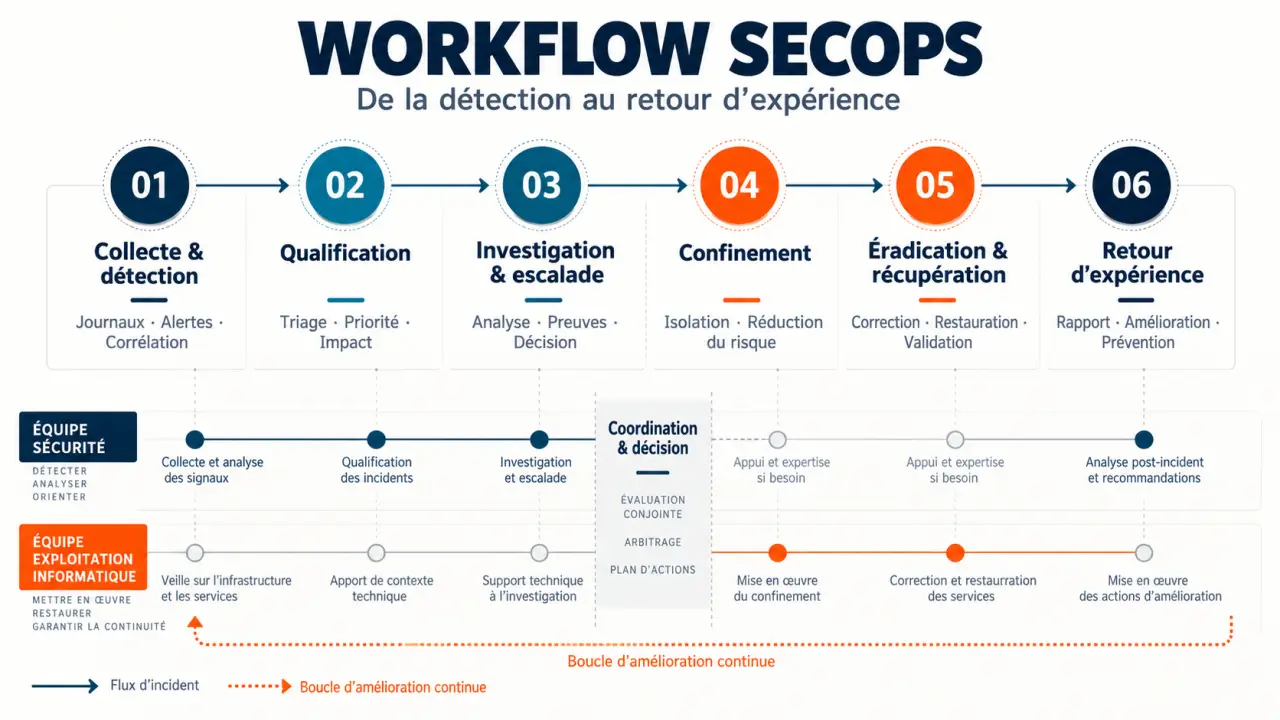
- Collecter et détecter : réunir les journaux d’authentification, les événements des terminaux et les traces d’accès aux données pour repérer une activité suspecte.
- Qualifier et hiérarchiser : vérifier si l’activité est légitime, identifier les ressources concernées et apprécier la gravité selon leur importance métier.
- Investiguer et escalader : reconstituer la chronologie, rechercher d’autres comptes touchés et solliciter les intervenants compétents.
- Contenir : révoquer les sessions, restreindre les accès ou isoler un terminal, selon les éléments établis et les autorisations prévues.
- Éradiquer et récupérer : supprimer la cause de la compromission, corriger la faiblesse exploitée et rétablir les services sous surveillance.
- Tirer les enseignements : documenter l’incident, adapter les détections et mettre à jour les procédures.
Un playbook, ou procédure de réponse, précise les vérifications, les responsables et les conditions d’intervention. Il évite d’improviser une décision sensible, comme isoler un serveur utilisé par plusieurs services. La conservation des éléments utiles à l’investigation doit aussi être anticipée.
La supervision continue ne dispense pas d’une recherche proactive. La chasse aux menaces explore des hypothèses de compromission qui n’ont pas encore déclenché d’alerte. Le renseignement sur les menaces apporte, lui, des informations sur les méthodes d’attaque et les indicateurs de compromission pour orienter ces recherches.
SIEM, SOAR, XDR : choisir les outils selon leur fonction
Un programme SecOps ne nécessite pas d’empiler tous les produits du marché. Le choix dépend des systèmes à couvrir, des compétences disponibles et des actions attendues. Les fonctions peuvent se recouper : il faut vérifier les intégrations réelles plutôt que se fier uniquement aux acronymes.
| Solution | Rôle principal | Point de vigilance |
|---|---|---|
| SIEM | Centraliser, analyser et corréler les journaux de sécurité. | La qualité des détections dépend des données collectées et des règles maintenues. |
| SOAR | Orchestrer les outils et automatiser des procédures de réponse. | Les actions sensibles nécessitent des garde-fous et des validations adaptées. |
| EDR | Détecter et investiguer les activités suspectes sur les terminaux, puis permettre une réponse. | Les équipements non couverts restent hors de son champ d’observation. |
| XDR | Relier des signaux provenant de plusieurs domaines : terminaux, identités, messagerie, réseaux ou cloud. | La couverture effective varie selon les connecteurs et les produits intégrés. |
| Sécurité cloud | Surveiller les configurations, les accès et les charges de travail cloud. | Les responsabilités du fournisseur et du client doivent être clarifiées. |
Une zone d’ombre mérite autant d’attention qu’une alerte : l’absence de signal ne signifie pas l’absence d’attaque. Un serveur qui ne transmet plus ses journaux peut sembler calme alors que la supervision est aveugle. Il est donc utile de contrôler la fraîcheur des événements, les interruptions de collecte et la couverture des actifs critiques. Cette surveillance de la surveillance évite une confiance trompeuse dans les tableaux de bord.
L’IA et le machine learning peuvent aider à rapprocher des événements ou à hiérarchiser les alertes. Ils ne remplacent ni le contexte métier ni la validation des analystes. Automatiser l’enrichissement d’une alerte présente généralement moins de risques que bloquer automatiquement un compte indispensable à la production.
Répartir les responsabilités avant d’automatiser
Les analystes SOC assurent le tri et l’investigation ; les ingénieurs sécurité entretiennent les intégrations et les détections. Les administrateurs systèmes, réseaux et cloud réalisent une partie des remédiations. Le responsable SecOps coordonne ces activités avec le RSSI et les responsables métier. Dans une petite structure, une même personne peut cumuler plusieurs fonctions, mais les responsabilités doivent rester explicites.
Les compétences utiles dépassent la maîtrise des outils : compréhension des réseaux, des systèmes et des identités, analyse de journaux, scripting, investigation et communication de crise. Savoir expliquer pourquoi une interruption est nécessaire compte autant que savoir déclencher une action technique.
L’externalisation peut apporter une capacité de supervision ou une expertise difficile à maintenir en interne. Elle ne transfère pas toutes les décisions au prestataire. Le contrat doit préciser le périmètre, les horaires de couverture, les modalités d’escalade, l’accès aux preuves et les personnes autorisées à agir sur les systèmes.
Démarrer avec un périmètre mesurable et des règles claires
Le premier chantier consiste à identifier les services critiques, leurs propriétaires et leurs dépendances. Mieux vaut superviser correctement un périmètre prioritaire que collecter massivement des données sans capacité d’analyse. Les coûts incluent les licences, mais aussi l’intégration, le stockage, la maintenance des règles et le temps humain.
- Cartographier : recenser les actifs, les identités sensibles et les sources de journaux indispensables.
- Prioriser : sélectionner des scénarios concrets, comme une compromission de compte ou un rançongiciel.
- Formaliser : définir la gravité des incidents, les circuits d’escalade et les procédures de réponse.
- Tester : simuler un incident pour vérifier la collecte, les décisions et le rétablissement.
- Améliorer : corriger les angles morts avant d’élargir le périmètre ou l’automatisation.
Pour mesurer les progrès, suivre les délais de détection, de qualification et de confinement, mais aussi les faux positifs et la couverture des actifs critiques. Ces indicateurs doivent avoir des définitions stables : une baisse du nombre d’alertes peut traduire un meilleur filtrage comme une collecte défaillante.
Enfin, SecOps contribue à la conformité par la traçabilité des accès, des incidents et des décisions. Il peut soutenir les exigences du RGPD, de PCI DSS ou d’ISO 27001, ainsi qu’une démarche fondée sur le NIST Cybersecurity Framework, sans garantir à lui seul la conformité. Les journaux doivent notamment être protégés, accessibles aux seules personnes habilitées et conservés pendant une durée justifiée.